Abres la analítica y aparece aocr.org entre las fuentes de visitas. En nuestras capturas de Matomo se repite ese referrer en varias entradas. Antes de dar por hecho que alguien te ha enlazado, conviene comprobar qué está contando realmente el panel y qué actividad hay detrás de esas visitas.
A 6 de noviembre de 2026 hay registros públicos e investigaciones que relacionan ese referrer con tráfico automatizado. La cuestión práctica es separar cuánto altera tus estadísticas y si está causando carga en el servidor. Son problemas distintos y requieren medidas distintas.
Qué significa que una visita venga de aocr.org
El referrer es el origen que se comunica al acceder a una página. En HTTP aparece en la cabecera Referer, con esa peculiar grafía. Que una petición incluya https://www.aocr.org/ no autentica su procedencia: un cliente automatizado puede enviar ese valor sin haber visitado el dominio.
Por eso, encontrarlo en el informe de referencias no acredita que allí exista un enlace hacia tu web, que sus responsables estén haciendo las peticiones o que el sitio haya sido comprometido. Para investigar el tráfico hay que mirar las peticiones que recibes, no atribuir responsabilidades a partir del nombre que llevan escrito.
Lo que muestran nuestras capturas de Matomo
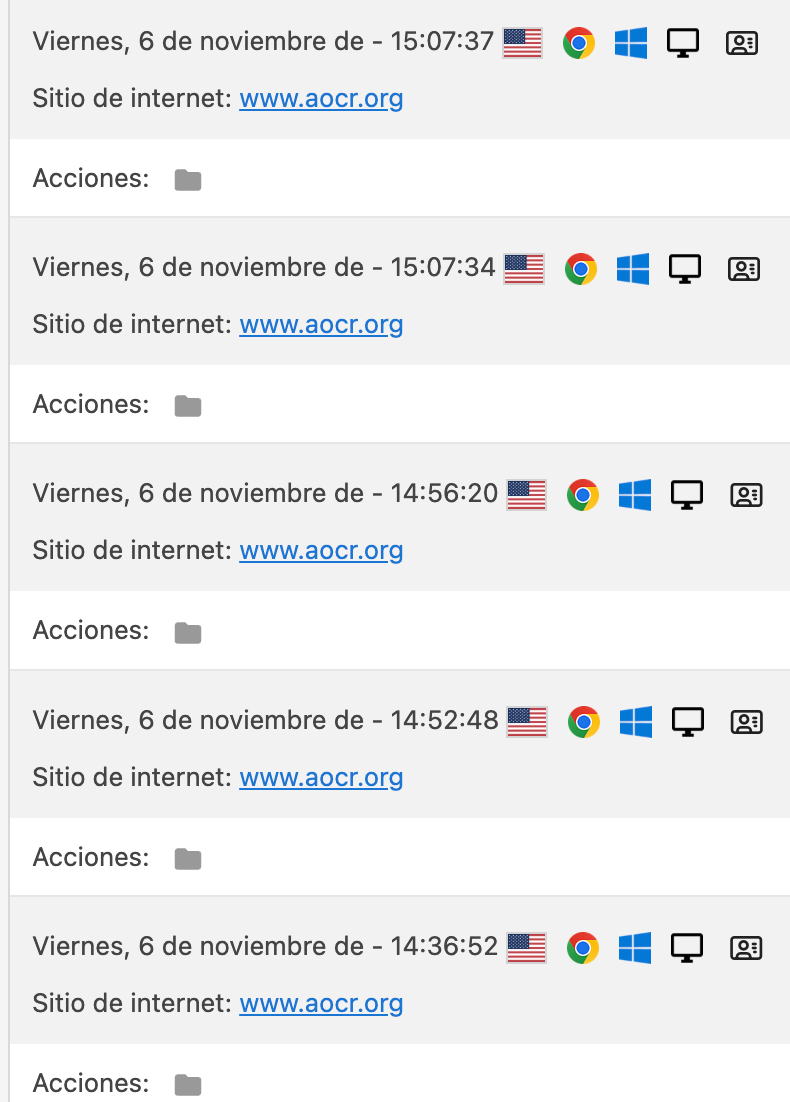
En nuestra analítica también aparece este referrer. La captura del 6 de noviembre de 2026 muestra cinco visitas con origen declarado www.aocr.org, a las 14:36:52, 14:52:48, 14:56:20, 15:07:34 y 15:07:37. En todas, el panel indica Estados Unidos, Chrome, Windows y un equipo de escritorio. Son las cinco entradas visibles en la imagen, no un recuento del día completo.
En otra captura, el detalle de un perfil informa de Chicago, Chrome 146 sobre Windows 10 y una resolución de 800 × 600. Registra una visita, una página, cero objetivos, una duración de 0 segundos y una carga media de 0,861 segundos. La ubicación y el software son los datos que muestra Matomo; no identifican por sí solos a una persona ni al operador del tráfico.
Los 0 segundos tampoco equivalen necesariamente a una permanencia real nula: como explica la documentación de Matomo, sin una acción posterior que permita estimar el tiempo, una visita de una sola página puede quedar registrada así. Esta muestra permite comparar el patrón con otras observaciones, pero no demuestra por sí misma un ataque ni un aumento del tráfico.
Qué se ha observado en los registros públicos
Un registro de PennyDreadfulMTG del 30 de septiembre de 2026 recoge una petición con ese Referer, un agente que se presenta como Chrome 146 sobre Windows 10, Sec-Fetch-Site: none y aceptación de imágenes HEIF. Es una muestra concreta de las cabeceras recibidas; el error de MySQL que aparece en el informe no establece por sí mismo una relación causal con un ataque.
La combinación del referrer con Sec-Fetch-Site: none merece atención. MDN documenta none para navegaciones sin un sitio de origen, como introducir una dirección o abrir un marcador. Esa incoherencia ayuda a seleccionar peticiones para revisarlas, pero las cabeceras también se pueden falsear: no convertiría ese único campo en una regla de bloqueo.
El efecto sobre las métricas aparece en una revisión pública de startaitools.com: su autor documentó en Umami, para el 20 de octubre, 2.768 sesiones con referrer aocr.org, resolución de 800 × 600 y un 99,6 % de rebote. Explica que el filtrado previo las había conservado y que estaban falseando la lectura del crecimiento. Son cifras de aquella instalación, útiles como patrón para contrastar con tus datos.
La investigación que apunta a infraestructura de scraping
En su investigación publicada el 29 de octubre, Tin describe coincidencias de huellas TLS y HTTP con Bytespider, referencias internas a forest en datos de temporización, proxies rotatorios y una observación mediante WebRTC asociada a China Mobile en Shanxi. Es un análisis técnico propio del autor que apunta a infraestructura de scraping.
La identidad del operador sigue abierta: las coincidencias no resuelven si actúa ByteDance o un cliente que utiliza esa infraestructura. Para administrar una web, lo aprovechable es el patrón observado y su impacto local; no hace falta resolver la atribución empresarial para proteger el servicio.
Cómo comprobar si te está pasando
Empezaría por conservar una muestra antes de cambiar filtros. Si borras o excluyes datos desde el primer momento, después cuesta saber qué eliminaste y si la medida funcionó.
- Delimita el periodo. Anota cuándo aparece el salto y compara intervalos equivalentes, con la misma zona horaria. Una mañana frente a un día entero puede fabricar una anomalía.
- Revisa servidor y CDN. Busca el referrer en los registros disponibles y agrupa las peticiones por hora, URL, estado HTTP y agente de usuario. Si hay CDN, distingue lo que atiende su caché de lo que llega al origen.
- Contrasta el comportamiento. Comprueba si se repiten secuencias de URLs, ritmos, resoluciones o sesiones sin interacción. La coincidencia de varias señales aporta más que una IP aislada.
- Mide el coste. Revisa latencia, carga, ancho de banda y errores durante esos intervalos. Un aumento de sesiones puede ensuciar un informe sin comprometer la disponibilidad.
- Compara dos lecturas. Conserva la vista original y prepara otra sin las sesiones sospechosas. Revisa cómo cambian las tendencias y los indicadores que utilizas para tomar decisiones.
No esperes que sesiones y peticiones HTTP coincidan una a una. Además de medir cosas distintas, intervienen la caché, la ejecución del código de analítica y la cobertura de los registros. Documenta qué estás contando en cada comparación.
GA4 y Matomo: limpiar informes no bloquea visitas
En GA4, añadir un dominio a las referencias no deseadas hace que se aplique ignore_referrer=true a los eventos afectados. Eso cambia el tratamiento del referrer; no elimina los eventos ni equivale a filtrar bots. Ocultar aocr.org como fuente puede dejar intacto el problema que intentabas medir.
Google también indica que GA4 excluye automáticamente bots conocidos. Esa protección no garantiza que identifique una automatización nueva.
En Matomo, o en cualquier otra herramienta, separa la segmentación de informes de la exclusión durante la recogida. Antes de aplicar un cambio permanente, verifica su alcance sobre los datos futuros y los históricos. Mantener una comparación reproducible permite detectar falsos positivos y explicar por qué una gráfica ha bajado después del ajuste.
Cuándo tiene sentido bloquear
Si el daño es estadístico, empieza por corregir la lectura de la analítica. Si las peticiones consumen recursos o degradan el servicio, actúa también en la capa HTTP con medidas proporcionales al comportamiento observado.
Una regla basada solo en el referrer resulta fácil de esquivar. Bloquear países o redes completas por un dato aislado amplía el daño potencial a visitantes legítimos. Define primero qué patrón quieres frenar, prueba su alcance y revisa los rechazos después de activarla. robots.txt tampoco es un control de acceso.
La comprobación final tiene dos partes: que las métricas vuelvan a representar actividad útil y que el servidor mantenga un servicio normal. Guarda el criterio aplicado y la fecha del cambio para poder interpretar la siguiente subida de tráfico.
Comentarios